La IA sigue masculinizando profesiones: investigadoras de HiTZ desarrollan herramientas para analizar sesgos de género en los sistemas de inteligencia artificial
Los sistemas de inteligencia artificial (IA) siguen asociando determinadas profesiones al género masculino, incluso cuando las referencias originales no especifican si se trata de una mujer o un hombre
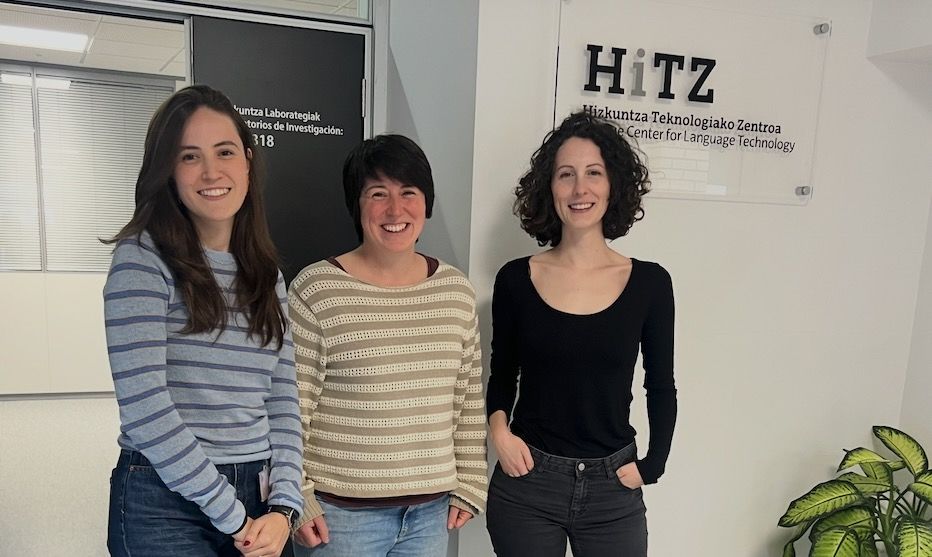
Para contribuir a detectar y corregir estos sesgos, investigadoras de HiTZ, el Centro Vasco de Tecnología del Lenguaje de la Universidad del País Vasco (EHU), han desarrollado nuevas herramientas de evaluación que permiten analizar con mayor precisión cómo los modelos de IA gestionan las referencias de género en distintos idiomas.
Tres investigadoras de HiTZ, el Centro Vasco de Tecnología del Lenguaje de la Universidad del País Vasco (EHU), han desarrollado nuevos recursos que permiten evaluar con mayor precisión los sesgos de género presentes en los sistemas de inteligencia artificial y traducción automática. El trabajo, firmado por Amaia Murillo, Olatz Perez de Viñaspre y Naiara Perez, ha sido presentado en la conferencia internacional LREC 2026 (Language Resources and Evaluation Conference), uno de los principales encuentros científicos del ámbito de las tecnologías del lenguaje.
La investigación parte de una pregunta clave: ¿cómo gestionan los sistemas de inteligencia artificial las referencias de género cuando trabajan con una lengua como el euskera, que no tiene género gramatical? Términos como irakaslea (docente) o garbitzailea (personal de limpieza) no indican si se refieren a una mujer o a un hombre, y los sistemas deben tomar una decisión cuando traducen estos términos a idiomas que sí distinguen entre masculino y femenino, como el castellano o el francés.
Para abordar este reto, las investigadoras han desarrollado dos nuevos recursos de evaluación: WinoMTeus y FLORES+Gender, que permiten medir de forma específica cómo los modelos de IA asignan el género en traducciones relacionadas con el euskera. Se trata de herramientas pioneras, ya que la mayoría de recursos existentes se han diseñado para el inglés y no tienen en cuenta las particularidades lingüísticas y culturales de otras lenguas.
Los recursos creados en el marco de esta investigación ya están disponibles para la comunidad científica y contribuirán al desarrollo de sistemas de IA más fiables, transparentes y sensibles a la diversidad lingüística y social, informan desde HiTZ.
Resultados del estudio
Los resultados muestran que los modelos actuales siguen presentando tendencias sesgadas a la hora de asignar género en las traducciones. En numerosos casos, los sistemas optan por formas masculinas incluso cuando se trata de profesiones desempeñadas mayoritariamente por mujeres, según EUSTAT. El estudio también detecta diferencias en el rendimiento de los modelos al procesar referencias masculinas y femeninas.
Más allá de identificar estas limitaciones, la principal contribución del trabajo es proporcionar nuevas herramientas que permitan medir y comparar de forma rigurosa el comportamiento de los sistemas de inteligencia artificial en contextos multilingües. Las investigadoras subrayan que disponer de métricas adaptadas a lenguas diversas es un paso fundamental para desarrollar tecnologías más inclusivas y representativas de la realidad social.
Las investigadoras destacan que incorporar lenguas menos representadas como el euskera a la investigación internacional sobre IA: "no solo contribuye a preservar la diversidad lingüística, sino que también permite identificar limitaciones y sesgos que pueden pasar desapercibidos en los grandes modelos de entrenamiento utilizados principalmente con datos de idiomas mayoritarios".
Link al artículo científico: https://lrec.elra.info/lrec2026-main-705
Sign up now at Comunicae Media. It's free!
Go to Comunicae Media